وقتی یک شرکت بزرگ ایرانی روزانه دهها هزار تیکت پشتیبانی، کامنت و پیام متنی دریافت میکند، هیچ تیم انسانی قادر به خواندن و دستهبندی لحظهای آنها نیست. اینجاست که نیاز به کدی که بتواند زبان محاوره، کنایه و غلطهای املایی کاربر فارسیزبان را مثل یک انسان بفهمد، به یک چالش جدی فنی تبدیل میشود.
فناوری پردازش زبان طبیعی دقیقاً برای حل همین بحران وارد معماری نرمافزارها شده است؛ ابزاری که به سیستمها اجازه میدهد متن و صوت خام را به دادههای ساختاریافته و قابل تحلیل برای ماشین تبدیل کنند. در این مقاله از کندو، بدون حاشیهرویهای تئوری، بررسی میکنیم که NLP در لایههای فنی چطور کار میکند، چه مراحل و چالشهایی در پیادهسازی واقعی دارد و چطور میتوانید از آن در پروژههای هوش مصنوعی و تحلیل داده استفاده کنید.
پردازش زبان طبیعی به چه معناست؟
کامپیوترها در حالت عادی فقط زبان صفر و یک و جدولهای دیتابیس را میفهمند؛ اما ما انسانها با کلمات، لحنهای مختلف و جملات پر از کنایه صحبت میکنیم. اگر بخواهیم خیلی ساده بگوییم پردازش زبان طبیعی چیست، باید آن را مترجمی بدانیم که بین زبان ما و منطق ریاضی کامپیوتر ارتباط برقرار میکند. در واقع، پردازش زبان طبیعی (nlp) ترکیبی از علم زبانشناسی و الگوریتمهای هوش مصنوعی است که جملات را به اجزای کوچکتر میشکند، کلمات را به بردارهای عددی تبدیل میکند و معنای واقعی پشت هر جمله را برای سیستم رمزگشایی میکند.
برای مثال، وقتی کاربری در سامانه پشتیبانی پیام میدهد «کارتم توی خودپرداز گیر کرده»، یک برنامه معمولی فقط کلمات را میبیند؛ اما سیستم مجهز به پردازش زبان طبیعی در هوش مصنوعی، فوریت پیام را درک میکند و بلافاصله تیکت را به بخش مسدودسازی کارت میفرستد. پیادهسازی چنین سیستمهایی نیازمند تسلط بر الگوریتمهای آماری و مدلهای زبانی است؛ مهارتهایی که در یک دوره ماشین لرنینگ به صورت عملی آموزش داده میشوند تا برنامهنویس بتواند به جای شرطهای ساده، مدلهای درک زبان بسازد.
NLP در چه زمینههایی کاربرد دارد؟
دامنه کاربرد پردازش زبان طبیعی از اسکریپتهای ساده دستهبندی ایمیل تا معماری مدلهای زبانی بزرگ (LLM) را پوشش میدهد. در بازار کار امروز، شرکتها برای حذف پروسههای دستی و درک سریعتر نیاز کاربران، از این فناوری در بخشهای زیر استفاده میکنند:
موتورهای جستوجو
گوگل و حتی موتورهای جستوجوی داخلی فروشگاههای بزرگی مثل دیجیکالا، دیگر صرفاً دنبال تطابق کلمات (Keyword Matching) نمیگردند. آنها با کمک NLP «نیت کاربر» (Search Intent) را میفهمند. مثلاً اگر کاربری سرچ کند «گوشی که باتریش زود خالی نشه»، موتور جستوجو ارتباط معنایی این جمله را با مشخصه فنی «ظرفیت باتری ۵۰۰۰ میلیآمپر به بالا» تشخیص میدهد و محصولات مرتبط را نمایش میدهد.
دستیارهای صوتی
سیستمهایی مثل Siri، الکسا یا دستیارهای صوتی فارسی، در دو مرحله کار میکنند: اول صدای شما را به متن تبدیل میکنند (Speech-to-Text) و بعد با الگوریتمهای NLP، دستور داخل متن را استخراج میکنند تا بفهمند باید آلارم گوشی را تنظیم کنند یا وضعیت آبوهوا را بخوانند.
ترجمه ماشینی
مترجمهای قدیمی کلمات را تکبهتک معنی میکردند و خروجی عجیب و غریبی تحویل میدادند. اما ابزارهای مدرن مثل Google Translate یا مدلهای ترجمه عصبی (NMT)، کل جمله را یکجا میخوانند و ساختار گرامری و اصطلاحات زبان مبدا را به معادل طبیعی آن در زبان مقصد برمیگردانند.
چتباتها
چتباتهای نسل جدید برخلاف باتهای قدیمی که فقط به دکمههای از پیش تعیینشده جواب میدادند، متن آزاد کاربر را تحلیل میکنند. امروزه بسیاری از بانکها و شرکتهای هاستینگ در ایران از این باتها برای پاسخگویی ۲۴ ساعته به سوالات فنی و پیگیری سفارشها بهره میبرند.
تحلیل احساسات
فرض کنید نسخه جدید اپلیکیشن شرکتتان را منتشر کردهاید و هزاران کامنت در کافهبازار یا توییتر ثبت شده است. الگوریتمهای تحلیل احساسات، بار عاطفی کلمات را میسنجند و نظرات را به سه دسته «مثبت»، «منفی» و «خنثی» تقسیم میکنند. حتی مدلهای پیشرفتهتر میتوانند لحن کنایهآمیز مثل «واقعاً دستتون درد نکنه با این آپدیت خراب!» را به عنوان نظر منفی تشخیص دهند.
خلاصهسازی متن
این قابلیت برای استخراج نکات کلیدی از متون طولانی مثل مقالات علمی، قراردادهای حقوقی یا گزارشهای طولانی سازمانی به کار میرود. در پیادهسازی فنی، خلاصهسازی به دو روش انجام میشود:
- استخراجی (Extractive): مدل مهمترین جملات موجود در متن اصلی را بدون تغییر جدا میکند و کنار هم میگذارد.
- انتزاعی (Abstractive): مدل کل متن را میفهمد و مثل یک انسان، خلاصه آن را با جملهبندی و کلمات جدید خودش بازنویسی میکند.
رفع ابهام
در زبان فارسی کلمات زیادی داریم که یک جور نوشته میشوند اما معنای متفاوتی دارند؛ مثل کلمه «شیر» یا «پروانه». الگوریتمهای رفع ابهام معنایی (Word Sense Disambiguation) با بررسی کلمات اطراف، تشخیص میدهند که منظور از «شیر» در جمله، شیر آب است، شیر خوراکی یا حیوان جنگل.
شناسایی موجودیتها
الگوریتمهای شناسایی موجودیتهای نامدار (NER) وظیفه دارند اطلاعات کلیدی و اسمهای خاص را از دل یک متن ساده بیرون بکشند و دستهبندی کنند. مثلاً وقتی متنی مثل «علی رضایی روز سهشنبه در دوره شبکه آموزشگاه کندو در تهران ثبتنام کرد» به سیستم داده میشود، مدل NER بهصورت خودکار این بخشها را تگگذاری میکند:
- نام شخص: علی رضایی
- زمان: روز سهشنبه
- نام سازمان: آموزشگاه کندو
- مکان: تهران
این قابلیت در اتوماسیون اداری، استخراج خودکار اطلاعات از رزومهها و دستهبندی سریع تیکتهای مشتریان کاربرد فراوانی دارد.
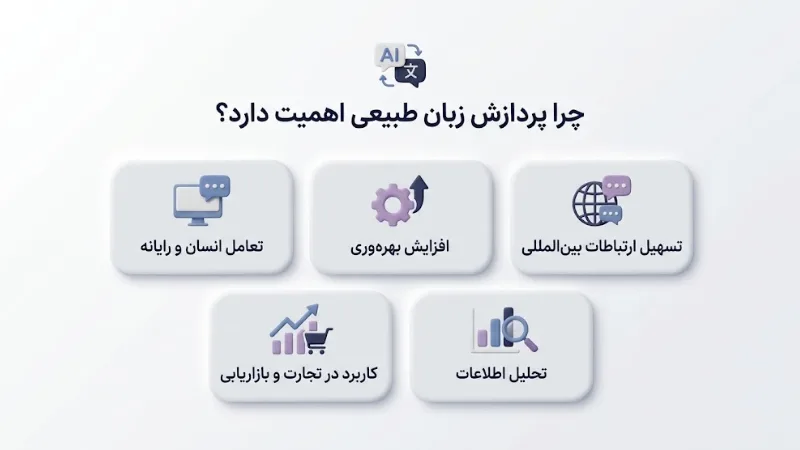
چرا پردازش زبان طبیعی اهمیت دارد؟
بیش از ۸۰ درصد دادههایی که روزانه در شرکتها، شبکههای اجتماعی و سیستمهای نرمافزاری تولید میشوند، «ساختارنیافته» هستند؛ یعنی در قالب ایمیل، چت، فایل صوتی و متنهای طولانی ذخیره میشوند که دیتابیسهای معمولی مثل SQL قادر به تحلیل محتوای آنها نیستند. اهمیت NLP دقیقاً در همین نقطه مشخص میشود: استخراج ارزش تجاری و فنی از دل دادههایی که قبلاً بلااستفاده میماندند.
1. تعامل انسان و رایانه
تا چند سال پیش، برای کار با سیستمها مجبور بودیم زبان آنها (کدنویسی یا کلیک روی منوهای پیچیده) را یاد بگیریم. پردازش زبان طبیعی این معادله را برعکس کرده است؛ حالا این کامپیوترها هستند که زبان ما را میفهمند. امروزه حتی در ابزارهای مدیریت سرور و امنیت، مهندسان میتوانند به جای نوشتن کوئریهای طولانی، به زبان ساده از سیستم بپرسند: «کدام آیپیها در یک ساعت گذشته بیشترین تلاش ناموفق برای ورود به سرور را داشتهاند؟» و لیست دقیق را تحویل بگیرند.
2. افزایش بهرهوری
در یک شرکت هاستینگ یا ارائهدهنده خدمات اینترنت (ISP)، روزانه هزاران تیکت ثبت میشود. اگر قرار باشد یک کارشناس انسانی تمام این تیکتها را بخواند و به دپارتمان فنی یا مالی ارجاع دهد، زمان زیادی هدر میرود. مدلهای NLP در کسری از ثانیه متن تیکت را میخوانند، موضوع را تشخیص میدهند، اولویتبندی میکنند و حتی برای سوالات تکراری مثل «نحوه تنظیم DNS»، پاسخ آماده میفرستند تا تیم فنی فقط روی مشکلات اصلی تمرکز کند.
3. تسهیل ارتباطات بینالمللی
محدودیت زبانی همیشه یکی از موانع بزرگ برای برنامهنویسان و شرکتهای فناوری در استفاده از منابع جهانی یا ورود به بازارهای بینالمللی بوده است. مدلهای ترجمه همزمان در جلسات آنلاین و ابزارهای مستندسازی خودکار، به تیمهای فنی کمک میکنند بدون نگرانی از تفاوتهای زبانی، داکیومنتهای فنی را به هر زبانی بخوانند یا محصول خود را برای کاربران غیرایرانی بومیسازی کنند.
4. کاربرد در تجارت و بازاریابی
بخش بزرگی از تصمیمگیریهای تجاری بر پایه بازخورد مشتریان انجام میشود. الگوریتمهای پردازش زبان با رصد مداوم نظرات کاربران در وبسایتها و شبکههای اجتماعی، به تیمهای مارکتینگ و محصول میگویند که مشتریان دقیقاً از کدام ویژگی محصول راضی هستند و کدام باگ یا کمبود، بیشترین نارضایتی را ایجاد کرده است.
5. تحلیل اطلاعات
خواندن هزاران صفحه گزارش مالی، لاگهای متنی یا مقالات پژوهشی برای هیچ انسانی در زمان کوتاه ممکن نیست. ابزارهای مبتنی بر NLP میتوانند در چند دقیقه میلیونها خط متن را اسکن کنند، الگوهای تکرارشونده را بیابند و ارتباط بین رخدادهای مختلف را در قالب یک گزارش مدیریتی کوتاه استخراج کنند.
چه عواملی بر پردازش زبان طبیعی تأثیر میگذارند؟
زمانی که از محیطهای آزمایشگاهی فاصله میگیریم و یک مدل زبانی را روی سرورهای عملیاتی (Production) شرکت پیاده میکنیم، میبینیم که دقت خروجی همیشه آن چیزی نیست که انتظار داشتیم. عملکرد و دقت نهایی یک سیستم NLP در دنیای واقعی به سه متغیر فنی زیر وابسته است:
کیفیت دادهها
اگر دیتاست آموزشی شما پر از تگهای اضافی HTML یا برچسبگذاریهای اشتباه باشد، مدل الگوهای غلط را یاد میگیرد. در زبان فارسی این موضوع حساستر است؛ مثلاً فعلی مثل «میشود» را کاربران گاهی با نیمفاصله، گاهی چسبیده (میشود) و گاهی با فاصله (می شود) تایپ میکنند. اگر این موارد قبل از آموزش مدل یکسانسازی نشوند، الگوریتم آنها را سه کلمه متفاوت به حساب میآورد و دقت سیستم افت میکند.
چندمعنایی واژهها
مدلهای قدیمی به هر کلمه فقط یک کد عددی ثابت میدادند و در تشخیص کلمات چندمعنایی به مشکل میخوردند. اما معماریهای جدیدتر مثل ترنسفورمرها (Transformers)، از مکانیزم «توجه» (Attention) استفاده میکنند؛ یعنی مدل کل کلمات قبل و بعد را میسنجد تا بفهمد واژه «باز» در یک جمله خاص، به معنای «پرنده شکاری» است یا «غیربسته».
پیچیدگی ساختار جملهها
کاربران طبق کتابهای دستور زبان تایپ نمیکنند. جملات طولانی، جابهجایی جای فاعل و فعل در لحن محاوره و ابهام در ضمایر، تحلیل متن را برای ماشین سخت میکند. مثلاً در جمله «سرور به فایروال وصل شد چون کانفیگ آن تغییر کرده بود»، تشخیص اینکه ضمیر «آن» به سرور برمیگردد یا فایروال، مستقیماً روی درستی خروجی مدل اثر میگذارد.
مراحل پردازش زبان طبیعی کداماند؟
پیادهسازی یک پروژه NLP در محیط واقعی، یک خط تولید (Pipeline) مهندسیشده دارد. برای اینکه متن خام کاربر به یک تصمیم یا پاسخ در سیستم تبدیل شود، دادهها چهار ایستگاه فنی زیر را طی میکنند:
گردآوری دادهها
اولین قدم، تامین سوخت اولیه مدل یعنی «پیکره متنی» (Corpus) است. در پروژههای واقعی، این دادهها را از دیتابیس تیکتهای قدیمی شرکت، لاگ چتها، API شبکههای اجتماعی یا با نوشتن اسکریپتهای وباسکریپینگ (با ابزارهایی مثل Scrapy یا BeautifulSoup) جمعآوری میکنیم. هرچه این دادهها به زبان واقعی کاربران هدف نزدیکتر باشد، مدل نهایی دقیقتر کار میکند.
برای آشنایی با نحوه ساخت پایپلاینهای جمعآوری اطلاعات، مقاله مهندسی داده چیست را بخوانید.
آمادهسازی و پیشپردازش دادهها
بخش عمده زمان متخصصان در همین مرحله میگذرد؛ چون متن خام برای الگوریتمها قابل هضم نیست. به دلیل گستردگی کاربرد پایتون در هوش مصنوعی، در پروژههای فارسی معمولاً از کتابخانههای پایتونی مثل Hazm یا DadmaTools برای انجام این چهار عملیات روی متن استفاده میکنیم:
- نرمالسازی (Normalization): یکسانسازی حروف عربی و فارسی (تبدیل «ي» و «ك» به «ی» و «ک») و اصلاح فاصلهها.
- توکنسازی (Tokenization): شکستن متنهای طولانی به جملات و کلمات مستقل (توکنها).
- حذف کلمات توقف (Stop Words): پاک کردن واژههای پرتکراری مثل «از»، «به»، «که» و «را» که بار معنایی خاصی به الگوریتم اضافه نمیکنند.
- ریشهیابی (Stemming / Lemmatization): رساندن کلمات مختلف به ریشه اصلی؛ مثلاً تبدیل «میروم»، «رفتم» و «بروند» به بنِ «رفت» تا حجم محاسبات مدل کم شود.
بررسی ساختار و معنای زبان
پس از تمیزکاری، نوبت به تبدیل کلمات به اعداد (Vectorization) و تحلیل آنها میرسد. در این فاز، سیستم در دو سطح روی متن کار میکند:
- تحلیل نحوی (Syntactic Analysis): مدل با بررسی گرامر جمله، نقش هر کلمه (فاعل، مفعول، فعل) را مشخص میکند تا ساختار جمله را بفهمد.
- تحلیل معنایی (Semantic Analysis): کلمات با روشهای Word Embedding به بردارهای عددی تبدیل میشوند تا مدل ارتباط مفهومی بین واژهها را درک کند (مثلاً متوجه شود کلمه «لپتاپ» از نظر معنایی به «کامپیوتر» نزدیک است، نه به «میز»).
تولید خروجی
در ایستگاه آخر، مدلِ آموزشدیده بر اساس هدفی که برایش تعریف کردهایم خروجی نهایی را میسازد. این خروجی میتواند یک برچسب ساده باشد (مثل تشخیص اسپم بودن ایمیل) یا تولید یک متن کاملاً جدید توسط مدلهای زبانی (NLG) برای پاسخ دادن به سوال مشتری در چتبات.
پردازش زبان طبیعی با چه چالشهایی روبهرو است؟
حتی با وجود مدلهای پیشرفتهای مثل GPT و ترنسفورمرها، پیادهسازی سیستمهای درک زبان در پروژههای تجاری بدون دردسر نیست. مهندسان هوش مصنوعی در محیط واقعی معمولاً با سه سد بزرگ روبهرو میشوند:
چندمعنایی زبان
بزرگترین چالش فنی در این حوزه، «ابهام در سطح جمله» است؛ یعنی زمانی که کل جمله را میتوان به دو شکل کاملاً متفاوت تفسیر کرد. مثلاً در جمله «پشتیبان فنی با عصبانیتِ مشتری، تیکت را بست»، برای یک الگوریتم ریاضی سخت است که تشخیص دهد چه کسی عصبانی بوده است؛ پشتیبان یا مشتری؟ این ابهامهای ساختاری باعث میشوند مدل در استخراج ارتباط بین اجزای جمله دچار خطا شود.
تفاوت میان زبانها
بیشتر الگوریتمها و مدلهای آماده دنیا بر پایه زبان انگلیسی ساخته شدهاند؛ در حالی که زبانهایی مثل فارسی، «کممنبع» محسوب میشوند و دیتاستهای استاندارد و برچسبخورده کمی دارند.
از طرفی، ساختار زبان فارسی چالشهای خاص خودش را دارد: ما در متنهای عادی «اعرابگذاری» نمیکنیم (مدل باید خودش تفاوت بین «کِرم» و «کَرَم» را بفهمد) و در فضای وب هم پدیدهای به نام «فینگلیش» یا ترکیب کلمات انگلیسی و فارسی در یک جمله داریم که توکنایزرهای استاندارد را به شدت گیج میکند.
درک مفاهیم پیچیده
الگوریتمها در تحلیل آمار و ریاضیات کلمات فوقالعاده عمل میکنند، اما چیزی به نام «درک شهودی» یا تجربه زیسته ندارند. به همین دلیل، وقتی متن شامل طعنه، شوخیهای فرهنگ عامه، استعاره یا اصطلاحات خیابانی میشود، مدلها به مشکل میخورند. مثلاً اگر کاربری زیر پست یک صرافی ارز دیجیتال بنویسد «با این سرعت سرورهای شما، سرمایهمون رفت هوا!»، مدل ممکن است به خاطر نبود کلمات منفی صریح، نتواند عمق شکایت و نارضایتی کاربر را تشخیص دهد.
جمع بندی
امروزه شرکتهای ایرانی برای تحلیل انبوه دادههای متنی و راهاندازی سرویسهای پشتیبانی خودکار، بیش از هر زمان دیگری به متخصصانی نیاز دارند که بتوانند مدلهای زبانی را بومیسازی و پیادهسازی کنند.ورود حرفهای به دنیای پردازش زبان طبیعی صرفاً با خواندن تئوریها اتفاق نمیافتد؛ بلکه نیازمند تسلط عملی بر برنامه نویسی هوش مصنوعی و کار با دیتاستهای واقعی است. . اگر میخواهید از یک برنامهنویس معمولی به مهندس هوش مصنوعی تبدیل شوید و پروژههای واقعی بازار کار را در دست بگیرید، یادگیری گامبهگام و پروژهمحور در دورههای تخصصی کندو دقیقاً همان سکوی پرتابی است که مسیر شغلی شما را تغییر میدهد.
سوالات متداول
۱. برای شروع یادگیری پردازش زبان طبیعی چه پیشنیازهایی لازم است؟
تسلط بر پایتون، آشنایی با آمار و جبر خطی پایه، و درک الگوریتمهای یادگیری ماشین تنها پیشنیازهای ورود به این حوزه هستند.
۲. آیا برای پیادهسازی پروژههای NLP همیشه باید مدل را از صفر آموزش دهیم؟
خیر؛ در بیشتر پروژهها از مدلهای از پیش آموزشدیده (مثل ParsBERT) استفاده میکنیم و فقط آنها را با دادههای جدید شرکت تنظیم دقیق میکنیم.
۳. تفاوت اصلی NLP با مدلهای زبانی بزرگ (LLM) مثل ChatGPT چیست؟
NLP شاخه مادر و کلی درک زبان در هوش مصنوعی است، اما LLMها زیرمجموعهای پیشرفته از آن هستند که با میلیاردها پارامتر برای تولید متنهای جدید آموزش دیدهاند.
